Stand 11.11.2026. Erfahrungsbericht zum ASRock 4U12G BC-250: ein ehemaliges Mining-Rig mit zwölf Karten, jede davon eine Sony-PS5-APU mit 16 GB GDDR6. Wir betreiben es ohne eine einzige Platte in den Karten: jede startet per Netzwerk von einem gemeinsamen Bootserver. Alle Zahlen sind an unserem Rig gemessen, die Bedingungen stehen jeweils dabei. Die einzelne Karte samt Speicheraufteilung, Governor und 40-CU-Freischaltung beschreibt die Seite KI-Box BC-250, hier geht es um das, was beim Zwölferpack dazukommt.
0. Kurzfassung
| Was | Ergebnis bei uns |
|---|---|
| Rig | ASRock 4U12G BC-250, 12 Karten, 2 Netzteile à 1200 W, 5 Lüfter, 200–240 V |
| Platten in den Karten | keine, außer einer NVMe in der Master-Karte (siehe 6) |
| Start | PXE → iPXE → Kernel und Initramfs per HTTP → Fedora 44 mit Root per NFS |
| Vom Wecken bis SSH | 57 s und 64 s gemessen (Wake-on-LAN, 3 von 3 Starts erfolgreich) |
| qwen3:14b Q4 (9,3 GB), 40 CUs | 35,1–35,2 T/s je Karte, gemessen an 3 Karten, 400 Token je Lauf |
| Modell laden über 1 GbE | 93–100 s (eine Karte allein), von NVMe 14,3 s |
| 40 CUs unter Last | 3 von 5 geprüften Karten bestehen, 2 fallen nach Sekunden aus und laufen mit 24 CUs |
| BIOS-Flash | keiner; je Karte zwei BIOS-Schalter für den Netzwerkstart |
Was das Rig nicht ist: ein großer Rechner. Es sind zwölf einzelne mit je rund 13 GiB nutzbarem Grafikspeicher. Ein Modell, das auf eine Karte passt, läuft zwölfmal parallel. Ein größeres Modell über mehrere Karten zu verteilen haben wir noch nicht gemessen.
1. Die Hardware
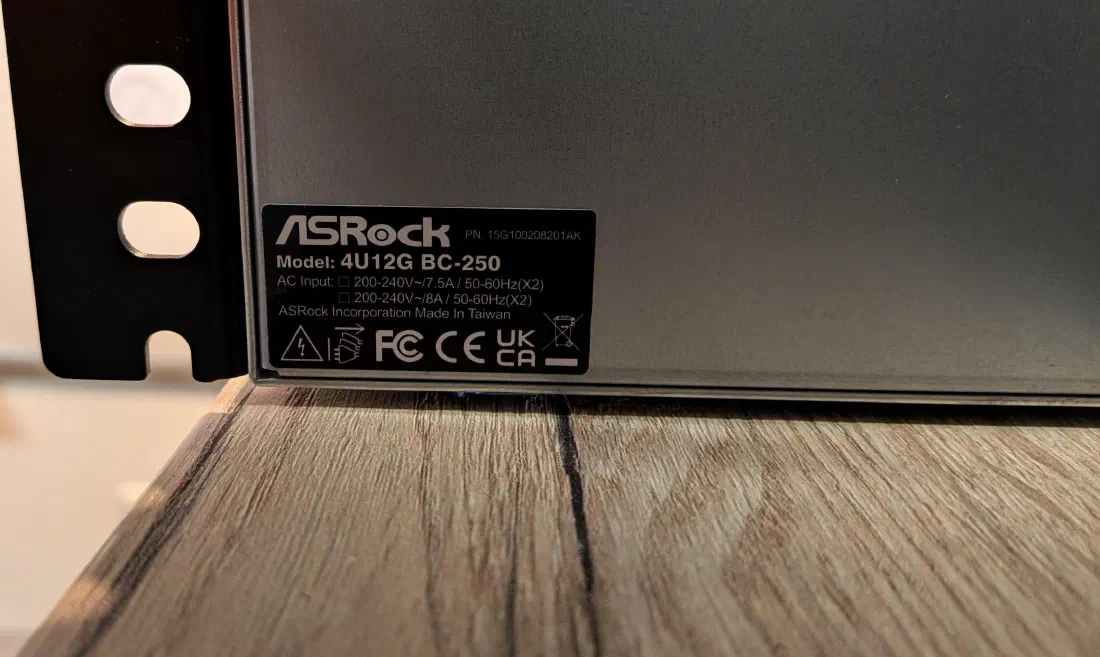
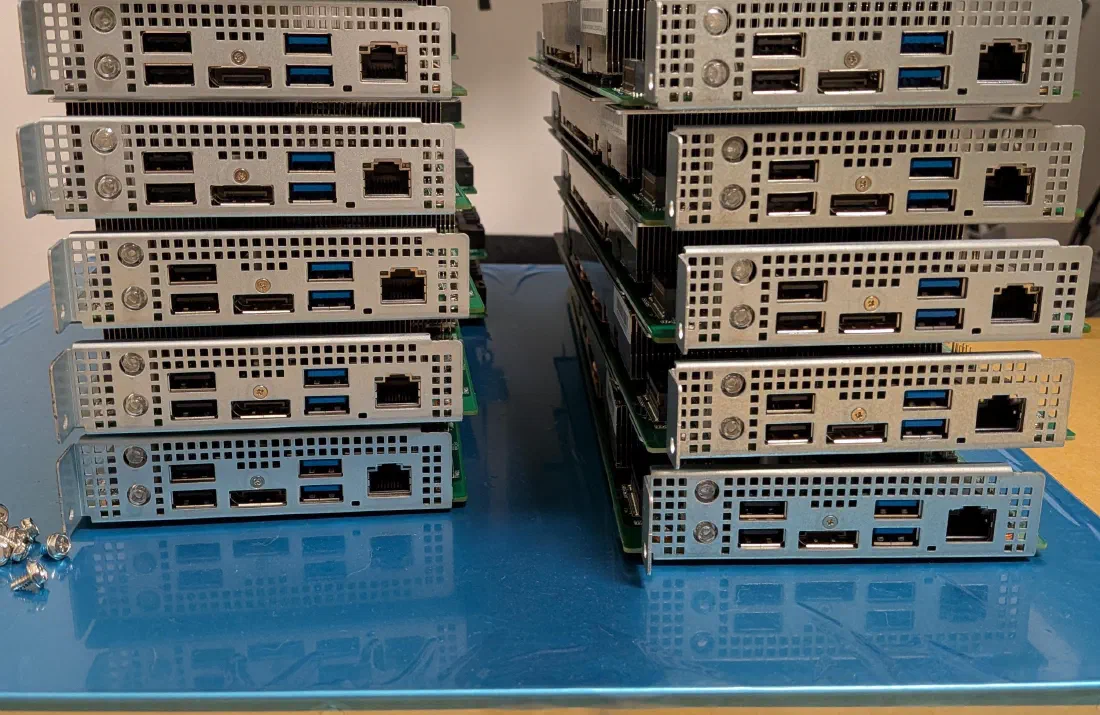
- Gehäuse: 4 Höheneinheiten, zwölf Steckplätze, eine Stromverteilerplatine mit je zwei 8-poligen Anschlüssen pro Karte.
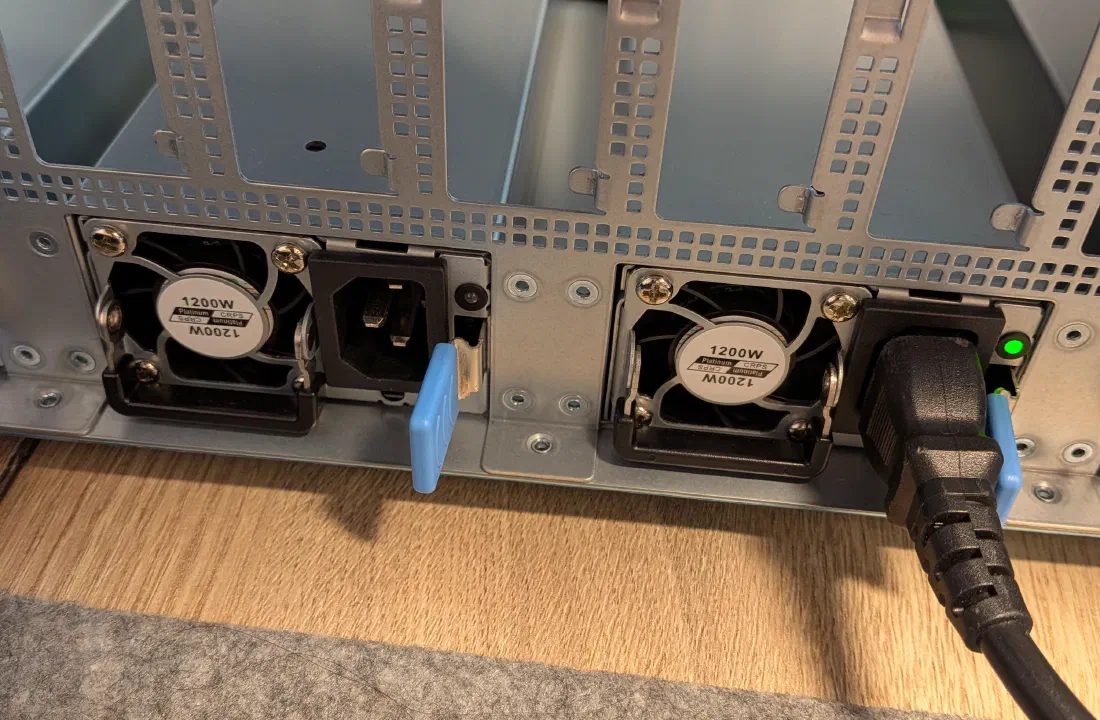
- Netzteile: zwei Stück mit je 1200 W (CRPS, im Betrieb tauschbar). Sie sind keine Reserve füreinander: jedes versorgt sechs Karten. Mit nur einem angeschlossenen Netzteil blieb bei uns die zweite Hälfte der Steckplätze dunkel.
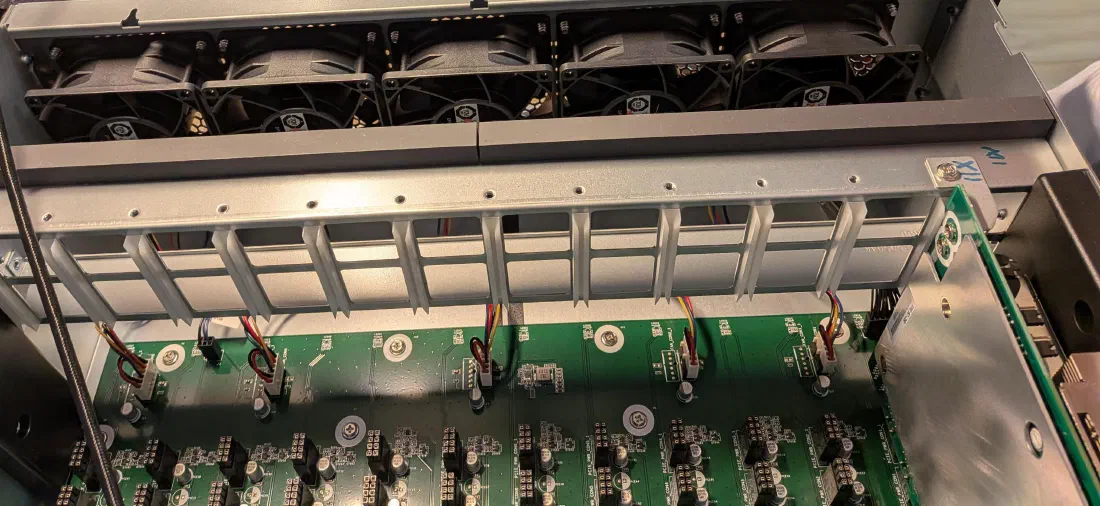
- Lüfter: fünf Stück an der Stirnwand, vieradrig angeschlossen. Im Leerlauf rund 8.700 U/min, unter Last 13.300 U/min. Es ist ein Gerät für den Serverraum.
- Karten: jede hat DisplayPort, vier USB-Anschlüsse, Gigabit-LAN und einen M.2-Steckplatz. Bei uns alle mit BIOS P2.00.
2. Warum ohne Platten
Zwölf NVMe kaufen, zwölfmal installieren und zwölf Systeme einzeln pflegen wollten wir nicht. Per Netzwerkstart gibt es ein System auf dem Bootserver, und eine neue Karte braucht nur Strom und ein Netzwerkkabel.
   Karte (ohne Platte)                 Bootserver (eine kleine VM)
   ───────────────────                 ───────────────────────────
   BIOS: PXE IPv4        ── DHCP ──▶   DHCP-Server nennt Bootserver + Datei
   lädt ipxe.efi         ◀─ TFTP ──    dnsmasq (nur TFTP)
   iPXE: boot.ipxe       ◀─ HTTP ──    nginx
   meldet sich an        ── HTTP ──▶   legt beim ersten Mal die Systemkopie
                                       der Karte an, gibt sie per NFS frei
   Kernel + Initramfs    ◀─ HTTP ──    nginx (150 MB)
   Fedora startet        ◀─ NFS  ──    Wurzeldateisystem der Karte
   Modell wird gelesen   ◀─ NFS  ──    Modelldateien, von allen geteilt
Der Bootserver ist eine Debian-VM mit vier Diensten: dnsmasq für TFTP, die
iPXE-Datei aus dem Debian-Paket, nginx und der NFS-Server. Die Boot-Optionen
liefert der vorhandene DHCP-Server. Wichtig ist dort ein eigener Dateiname für
iPXE, sonst lädt iPXE nach dem Start wieder sich selbst.
3. Je Karte: zwei BIOS-Schalter
Der Netzwerkstart ist ab Werk aus. Jede Karte braucht einmal Monitor und Tastatur (Entf beim Start, Reiter Advanced):
- Network Stack auf Enabled
- danach Ipv4 PXE Support auf Enabled
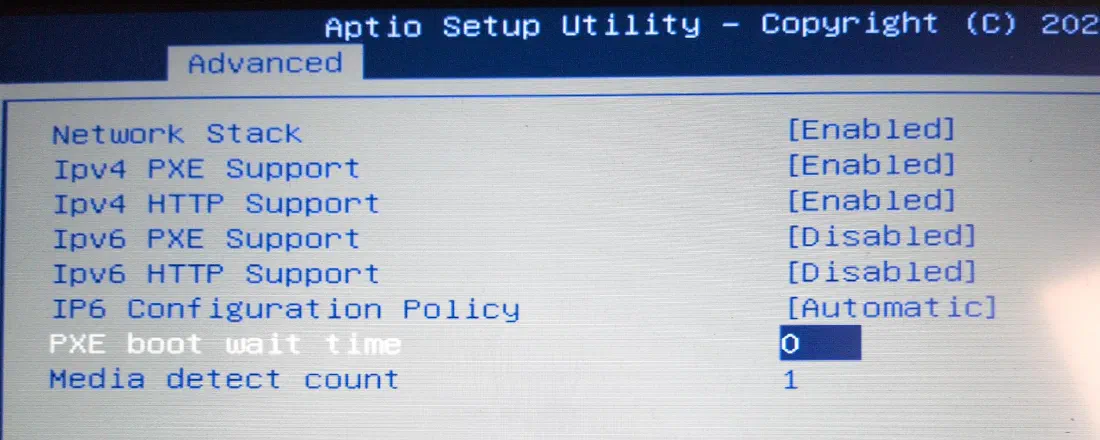
IOMMU bleibt aus, wie bei der Einzelkarte. Alles Weitere geschieht ohne Bildschirm: Die Karte meldet sich beim Bootserver an und bekommt ihr System. Die Speicheraufteilung (512 MB fest, der Rest dynamisch) muss ebenfalls einmal je Karte gesetzt werden, das geht aus der Ferne und braucht einen Neustart.
4. Das System der Karten
Das Abbild ist ein Fedora 44 mit demselben Stand wie unsere Einzelkarte: Kernel 7.3.3, Mesa 26.2.6 (Vulkan), GPU-Governor, Ollama 0.40.13 und die 40-CU-Freischaltung als Dienst. Gebaut wird es auf dem Bootserver in einen Ordner, das Initramfs enthält Netzwerktreiber und NFS.
Jede Karte bekommt beim ersten Start automatisch eine eigene Kopie dieses Ordners (bei uns 35–50 s). Die Modelldateien werden nicht kopiert, sondern von allen Karten gemeinsam gelesen. Der Rechnername entsteht aus der MAC-Adresse.
Das ist die schnelle Lösung. Sie hat zwei Nachteile, die wir noch beheben: Jede Kopie kostet 4,6 GB, und eine spätere Änderung am Abbild erreicht die vorhandenen Kopien nicht von selbst. Das Ziel ist ein gemeinsames, nur lesbares Abbild mit einem flüchtigen Schreibbereich je Karte.
5. Messwerte
Alle Werte mit qwen3:14b (Q4, 9,3 GB), Ollama über Vulkan, 400 Token je Lauf.
| Messung | Ergebnis | Bedingung |
|---|---|---|
| Generierung, 40 CUs | 35,1–35,2 T/s | drei Karten einzeln gemessen |
| Takt und Temperatur unter Last | 1850 MHz ohne Drosselung, 71–79 °C | Master-Karte rechnet mit, Lüfter 13.300 U/min |
| Eine Karte ohne Lüfterhilfe | nach rund einer Minute 85 °C, Drosselung auf 1430 MHz, 33,9 T/s | nur diese Karte unter Last, Lüfter auf Grundstufe |
| Einzelkarte im Druckgehäuse zum Vergleich | 35,2 T/s, drosselt nach etwa 100 s auf rund 1490 MHz | siehe KI-Box |
| Wecken per Wake-on-LAN bis SSH | 57 s und 64 s | 3 von 3 Starts erfolgreich |
| Neustart aus dem laufenden System | startet wieder per PXE | mehrfach an mehreren Karten |
| Modell laden über das Netz | 93–100 s | eine Karte lädt allein |
| Zwei Karten laden gleichzeitig | rund 6 min | Bootserver mit 2 GB RAM, eine Gigabit-Leitung |
| Modell laden von NVMe | 14,3 s | Master-Karte, Steckplatz mit PCIe 2.0 x2 |
Anderswo liest man, die Netzwerkkarte des BC-250 starte nach einem Warm-Neustart nicht zuverlässig per PXE. Bei uns hat es in jedem Versuch funktioniert. Das sind einige Dutzend Starts an einem Tag, kein Langzeitbeleg.
6. Die Master-Karte und die Lüfter
Die fünf Lüfter folgen nur der Temperatur einer einzigen Karte, bei uns der im äußersten Steckplatz. Nur sie sieht die Lüfter überhaupt, alle anderen melden 0 U/min. Die Folgen haben wir gemessen:
- Rechnet eine andere Karte allein, bleibt die Lüfterdrehzahl auf Grundstufe. Die rechnende Karte erreicht nach gut einer Minute 85 °C und bremst sich selbst.
- Ist die Master-Karte aus, stehen die Lüfter fast. Eine Karte, die dann noch eingeschaltet ist, bekommt kaum Luft.
Wir behandeln diese Karte deshalb als Master: Sie läuft immer, und Lasttests fahren wir nur, wenn sie mitrechnet.
Warum ausgerechnet diese Karte eine NVMe hat
Elf Karten kommen ohne Platte aus, die Master-Karte nicht. Drei Gründe, alle aus dem eigenen Aufbau:
- Sie darf nicht am Bootserver hängen. Eine Karte ohne Platte hat ihr ganzes System auf dem Bootserver. Fällt der weg, steht sie. Das ist uns im Test passiert: Ein Script nahm die Freigaben zurück, während Karten liefen, und wir mussten das Rig am Schalter ausschalten. Bei einer gewöhnlichen Karte ist das ärgerlich. Bei der Master-Karte hieße es, dass die Lüfter für alle zwölf wegfallen. Mit eigener Platte läuft sie weiter, auch wenn der Bootserver gewartet wird oder ausfällt.
- Sie muss als Erste bereit sein. Weil kein Lasttest ohne sie läuft, wartet alles auf ihr Modell. Über das Netz dauert das Laden 93–100 s, bei zwei Karten gleichzeitig rund sechs Minuten. Von der NVMe sind es 14,3 s.
- Eine Platte ist kein Widerspruch zu „ohne Platten“. Es bleibt bei einer NVMe statt zwölf. Eine gebrauchte 120-GB-Platte reicht, belegt sind 14 GB. Eine zweite, geklonte Platte liegt als Reserve bereit. Ihren Start haben wir noch nicht geprüft.
Der Netzwerkstart bleibt bei der Master-Karte als zweiter Eintrag in der Startreihenfolge erhalten. Fällt die Platte aus, startet sie wie die anderen vom Bootserver.
Eine Regelung nach der heißesten Karte im Rig haben wir noch nicht. Der Sensortreiber im Kernel kann den Lüfterregler nur lesen.
7. 40 Recheneinheiten: nicht jede Karte
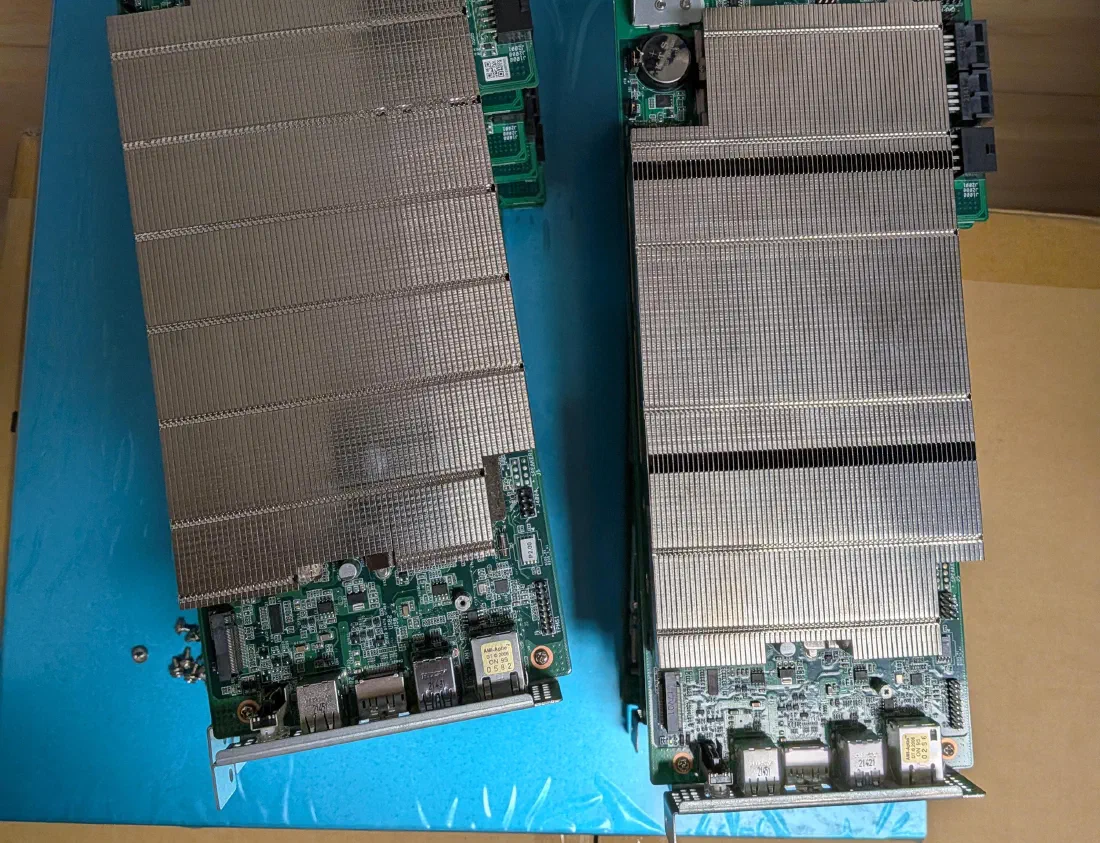
Ab Werk sind 24 der 40 Recheneinheiten der Grafikeinheit aktiv. Die restlichen 16 lassen sich zur Laufzeit zuschalten, das bringt rund 30 % mehr Durchsatz. Die Community-Doku warnt, dass das nicht bei jeder Karte sauber funktioniert. Wir können das bestätigen:
| Karten | Ergebnis mit 40 CUs unter Last |
|---|---|
| 3 Karten | bestanden: 6 bis 17 Läufe ohne Fehler |
| 2 Karten | durchgefallen: ring gfx_0.0.0 timeout nach wenigen Sekunden, danach rechnet die Karte nicht mehr |
| 7 Karten | 40 CUs aktiv, unter Last noch nicht geprüft |
Im Leerlauf fällt der Fehler nicht auf, die Zuschaltung meldet Erfolg. Er zeigt sich erst beim Rechnen. An der Temperatur lag es nicht: Eine der beiden Karten fiel bei 63 °C aus. Mit den 24 Einheiten ab Werk starten beide sauber.
Unser Rig enthält zwei Serien, erkennbar an den Aufklebern: neun Karten der einen, drei der anderen. Beide Ausfälle liegen in der Dreiergruppe, die dritte Karte dieser Gruppe besteht den Test. Bei fünf geprüften Karten ist das eine Beobachtung und kein Beweis für eine schlechtere Serie.
Die Lehre für den Betrieb: Jede Karte einzeln unter Last prüfen, bevor die 40 CUs dauerhaft eingeschaltet werden.
8. Stolpersteine
- Karten nicht unter Strom stecken. Im Betrieb tauschbar sind die Netzteile, nicht die Karten an ihren 8-poligen Steckern.
- Kein Kabel, kein System, keine Kühlung. Eine eingebaute Karte ohne Netzwerkkabel bleibt in der Netzwerksuche stehen und ist trotzdem an.
- Laufenden Karten nie die NFS-Freigabe entziehen. Die Karte verliert ihr System, steht noch am Login und nimmt keinen Befehl mehr an, auch kein Herunterfahren. Es hilft nur der Netzschalter.
- Modell laden bremst die Nachbarn. System und Modell kommen über dieselbe Leitung. Während eine Karte lädt, reagieren die anderen zäh. Karten deshalb nacheinander wecken, und der Bootserver braucht mehr Arbeitsspeicher als das größte Modell.
- Feste Adressen im dynamischen DHCP-Bereich. Eine Karte bekam bei uns die Adresse eines ausgeschalteten Geräts samt dessen Namen. Die Karten brauchen eigene, feste Adressen außerhalb des dynamischen Bereichs.
- Der erste Start einer Karte dauert länger. Bis ihre Systemkopie fertig ist, zeigt der Bildschirm wiederholt „access denied“. Das löst sich von selbst.
- Protokoll über NFS. Die Meldung „Failed to set ACL“ beim Anmelden ist harmlos. Das Protokoll wird über das Netz aber nur alle paar Minuten festgeschrieben und taugt nach einem harten Ausschalten nicht als Beleg.
- Angaben zum BIOS prüfen. Uns wurde P3.00 genannt, alle zwölf Karten melden P2.00. Für den Betrieb hier spielt es keine Rolle.
9. Was noch offen ist
- Die sieben ungeprüften Karten unter Last abnehmen.
- Lüfter nach der heißesten Karte regeln oder auf eine feste, sichere Stufe stellen.
- Ein gemeinsames, nur lesbares Abbild statt zwölf Kopien.
- llama.cpp gegen Ollama messen und ein Modell über zwei Karten verteilen. Gebaut ist llama.cpp mit Vulkan bereits, gemessen noch nicht.
- Überwachung: Temperatur je Karte und automatisches Herunterfahren, wenn die Master-Karte oder ihr Netzteil ausfällt.
- Leistungsaufnahme des ganzen Rigs messen. Dazu haben wir noch keinen eigenen Wert.
10. Quellen
- Einzelkarte, Speicheraufteilung, Governor, 40 CUs: KI-Box BC-250 mit den dortigen Quellen
- Community-Doku BC-250 (elektricM): https://elektricm.github.io/amd-bc250-docs/
- 40-CU-Freischaltung zur Laufzeit (WinnieLV): https://github.com/WinnieLV/bc250-cu-live-manager
- Disklose BC-250-Rigs für Mining, mit den BIOS-Schaltern (TheJames5): https://github.com/TheJames5/hiveos-pxe-diskless
- NixOS-Netboot-Abbild für den BC-250, von uns nicht eingesetzt (n3oney): https://github.com/n3oney/bc250-nixos
- iPXE: https://ipxe.org/ · dnsmasq: https://thekelleys.org.uk/dnsmasq/doc.html
- llama.cpp: https://github.com/ggml-org/llama.cpp